좋은 선생을 베껴도 무너졌다
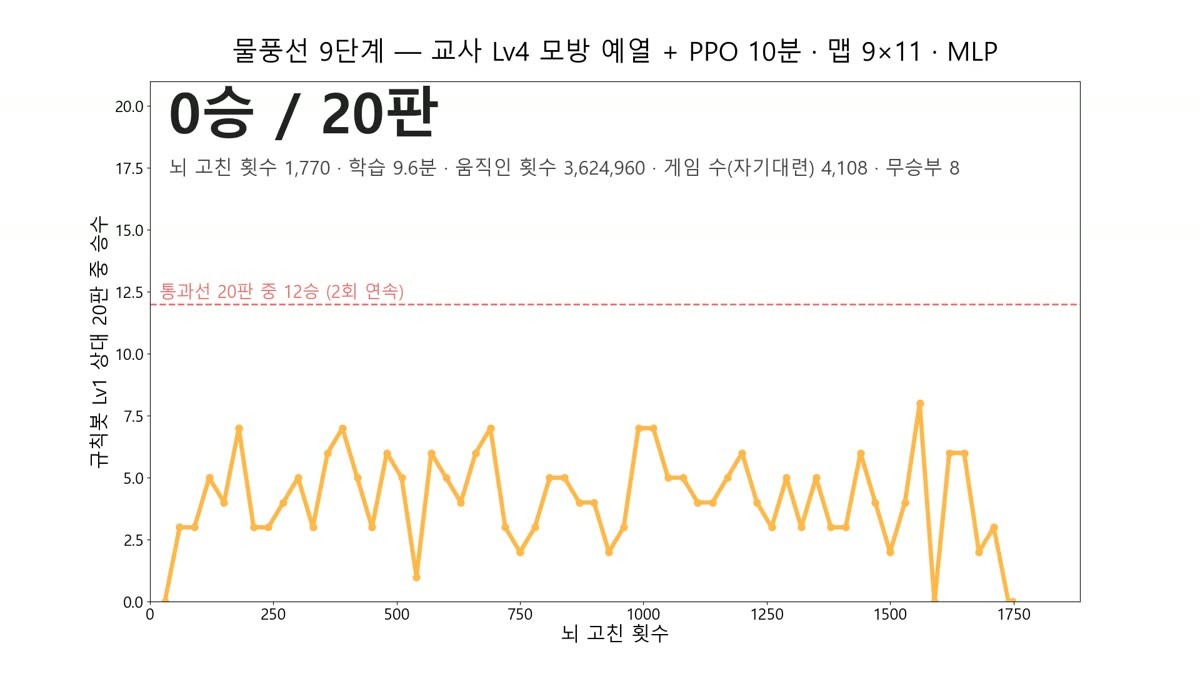
다음 시도는 선생 역할을 하는 규칙 봇이었습니다. 사람이 짠 규칙으로 가장 잘 두는 4단계 규칙 봇을 만들고, AI가 그 봇의 행동을 먼저 따라 하게 했습니다. 출발점을 좋게 하려는 생각이었습니다. 선생 봇은 공개된 소스의 봇을 분석해, 풍선을 놓고 피하는 방식으로 짰습니다. 원작의 자산은 쓰지 않았습니다.
선생 봇은 시험을 모두 통과했습니다. 상대가 3단계 봇 셋일 때 승률이 76.5%였고, 1단계 봇 셋일 때는 86.5%였습니다. 자기 풍선에 스스로 갇혀 죽는 비율도 1.8%로 낮았습니다. AI도 선생의 행동을 74% 정도 따라 했습니다. 여기까지는 잘 되었습니다.
문제는 그 뒤의 학습이었습니다. 10분 동안 학습시키자 한 판에 놓는 풍선 수가 0.99에서 0.37로, 다시 0.19로 떨어졌습니다. 선생이 준 출발점을 학습이 오히려 망가뜨린 것입니다. 100판으로 다시 재 보니, 따라 하기만 한 뇌는 6승이었는데 학습을 마치자 0승에서 1승이었습니다. 1단계 규칙 봇과 20판을 했을 때 최고 7승을 한 번 기록하긴 했지만, 그것으로는 안정적인 실력이라고 할 수 없었습니다.
결국 학습의 목표 자체가 풍선을 놓지 않는 쪽을 좋게 보고 있었다는 결론이 났습니다. 기록에는 이렇게 적었습니다. 학습은 순위 보상과 자기 풍선 -1이라는 목표를 따르는데, 출발점이 무엇이든 안 놓기 쪽으로 끌어내린다. 출발점을 바꿔도 목표가 같으면 결국 같은 곳으로 돌아갑니다.
실패는 그대로 기록했습니다. 그 뒤 운영자는 학습을 잠시 미루고, 선생 역할의 규칙 봇을 더 세고 빠르게 다듬는 일을 먼저 하기로 정했습니다. 좋은 선생을 베끼는 것만으로는 부족하다는 것을 이 실험으로 알았습니다.
규칙 봇 다듬기도 쉽지 않았습니다. 다섯 가지 손잡이를 시험했는데, 넷은 이득이 기준에 못 미치거나 행동이 달라지지 않아 되돌렸습니다. 남긴 것은 속도 하나로, 행동은 100% 같게 두고 원래 크기 맵에서 한 번 결정하는 시간을 121.8마이크로초에서 45.8마이크로초로 줄였습니다.
다음 날에는 따라 하는 시간을 두 배로 늘려 보았습니다. 따라 한 정도는 74.2%에서 75.6%로, 100판 최고는 24승에서 29승으로 조금 올랐지만, 마지막 뇌는 19승에서 16승으로 내려갔습니다. 이때는 다른 실험과 처리 장치를 나눠 써서 비교에 주의가 필요합니다.